PDFの資料から文字をコピーできず、結局そのまま打ち直した経験はありませんか。スキャンした請求書や注文書だと、文字を選択すらできません。毎日の転記作業、正直うんざりしますよね。この記事では、PDFのテキスト抽出を無料ツールからAI OCRまで整理します。業務効率化につなげる手順を、順番にお伝えします。
この記事でわかること
- 文字を選べる「テキストPDF」と、スキャンの「画像PDF」の見分け方
- 無料ツールとAI OCRの使い分け、どんなときにどれを選ぶか
- PDFのテキスト抽出を自動化する5つの手順
- OCRエラーが起きる原因と、現場での具体的な対処法
結論から先に:文字を選べるPDFはコピーやWord変換、画像PDFはOCRでテキスト抽出します。定型の帳票を大量に扱うなら、読み取りから転記まで自動化できるAI OCRが近道です。
そもそもPDFのテキスト抽出とは?
PDFのテキスト抽出とは、PDF内の文字を、編集できるテキストデータとして取り出すことです。
同じPDFでも、中身は大きく2種類に分かれます。1つは、WordやExcelから書き出した「テキストPDF」。文字情報を持っているため、そのまま選択してコピーできます。
もう1つは、紙をスキャンした「画像PDF」です。見た目は文字でも、中身は写真と同じ画像。選択もコピーもできず、ここでOCRの出番になります。
OCRとは、画像の中の文字をコンピューターが認識し、テキストデータに変換する技術です。スキャンした紙やPDFの画像から文字を読み取り、手入力の代わりに自動でデータ化できます。
つまり、まず見分けるべきは「選べるPDF」か「画像のPDF」か。ここを取り違えると、ツール選びごとつまずきます。
PDFのテキスト抽出で、業務は何が変わる?
PDFをテキスト化すると、検索・再利用・転記の手間がまとめて軽くなり、入力ミスも減らせます。
紙やPDFのままでは、必要な数字を探すだけでも時間がかかります。テキストにしておけば、ファイル内検索で一瞬。Excelへの貼り付けや再集計も自由自在です。
- キーワード検索で、目的の1行をすぐに見つけられる
- 手入力の打ち直しが不要になり、転記ミスが起きにくい
- Excelや基幹システムへそのまま流し込み、再利用できる
サポートの立場で見ていると、気づくことがあります。手入力そのものより、後からの「探す・直す」に時間を奪われている方が多いのです。抽出して検索できる状態にするだけで、日々の確認作業がぐっと楽になります。
紙から解放された時間を、本来の判断や段取りに回す。これこそ、テキスト抽出のいちばんの価値。まずは自社のPDFで、どれだけ手入力が減らせそうか見てみてください。
自動化の全体像をつかんだら、実際の無料トライアルで試すのが早道です。
PDFからテキストを抽出する方法|無料ツールとAI OCRの使い分け
抽出方法は、PDFの種類で選び分けます。文字を選べるPDFはコピーやWord変換、スキャンの画像PDFはOCRツールが基本です。
代表的な手段を、手軽さと向き不向きで整理します。少量ならまず無料ツール、定型帳票の大量処理なら専用のAI OCR、という考え方が基本です。
| 方法 | 向いているPDF | 特徴 |
|---|---|---|
| コピー&ペースト | テキストPDF | ツール不要。少量ならいちばん速い |
| Word・Googleドキュメント変換 | テキスト/一部の画像PDF | レイアウトは崩れがち。整形の手直しが要る |
| 無料OCRツール | 画像PDF(少量) | 手軽だが、枚数が多いと手作業が増える |
| AI OCR(専用ツール) | 画像PDF(大量・定型) | 読み取りから転記まで自動化できる |
無料ツールの比較は、別記事で安全性とあわせてまとめています。Google系の変換はGoogleの無料OCRでPDFを変換する方法が参考になります。10種類の比較は無料で使えるOCRフリーソフト徹底比較をご覧ください。
PDFからExcelへ取り込みたい場合は、OCRでPDFからエクセルへ変換するコツが参考になります。生成AIで読み取る手順と限界は、ChatGPTで画像の文字を読み取る方法をご覧ください。目的に近い記事から選んでください。
ツール選びで一つ補足です。導入担当として現場でよく出会うのが、Excelで作って印刷した帳票をOCRにかけようとするケース。元データがデジタルで残っているなら、紙を読み直すのは遠回りです。
その場合はOCRを使わず、マクロやRPAで直接つなぐ方が確実で速い。道具ありきではなく、業務のどこに紙が挟まっているかから手段を選ぶ。ここが遠回りを避けるコツです。項目抽出の考え方はエクセルで必要な項目を抽出して表を作る方法も参考になります。
PDFのテキスト抽出を自動化する手順
自動化は、PDFの種類の見分けから定着までの5ステップで進めると、無理なく回り始めます。
いきなりツールを選ばず、まず対象のPDFと流れを整理するのが成功の近道です。手を動かす前に、次の順番を押さえてください。
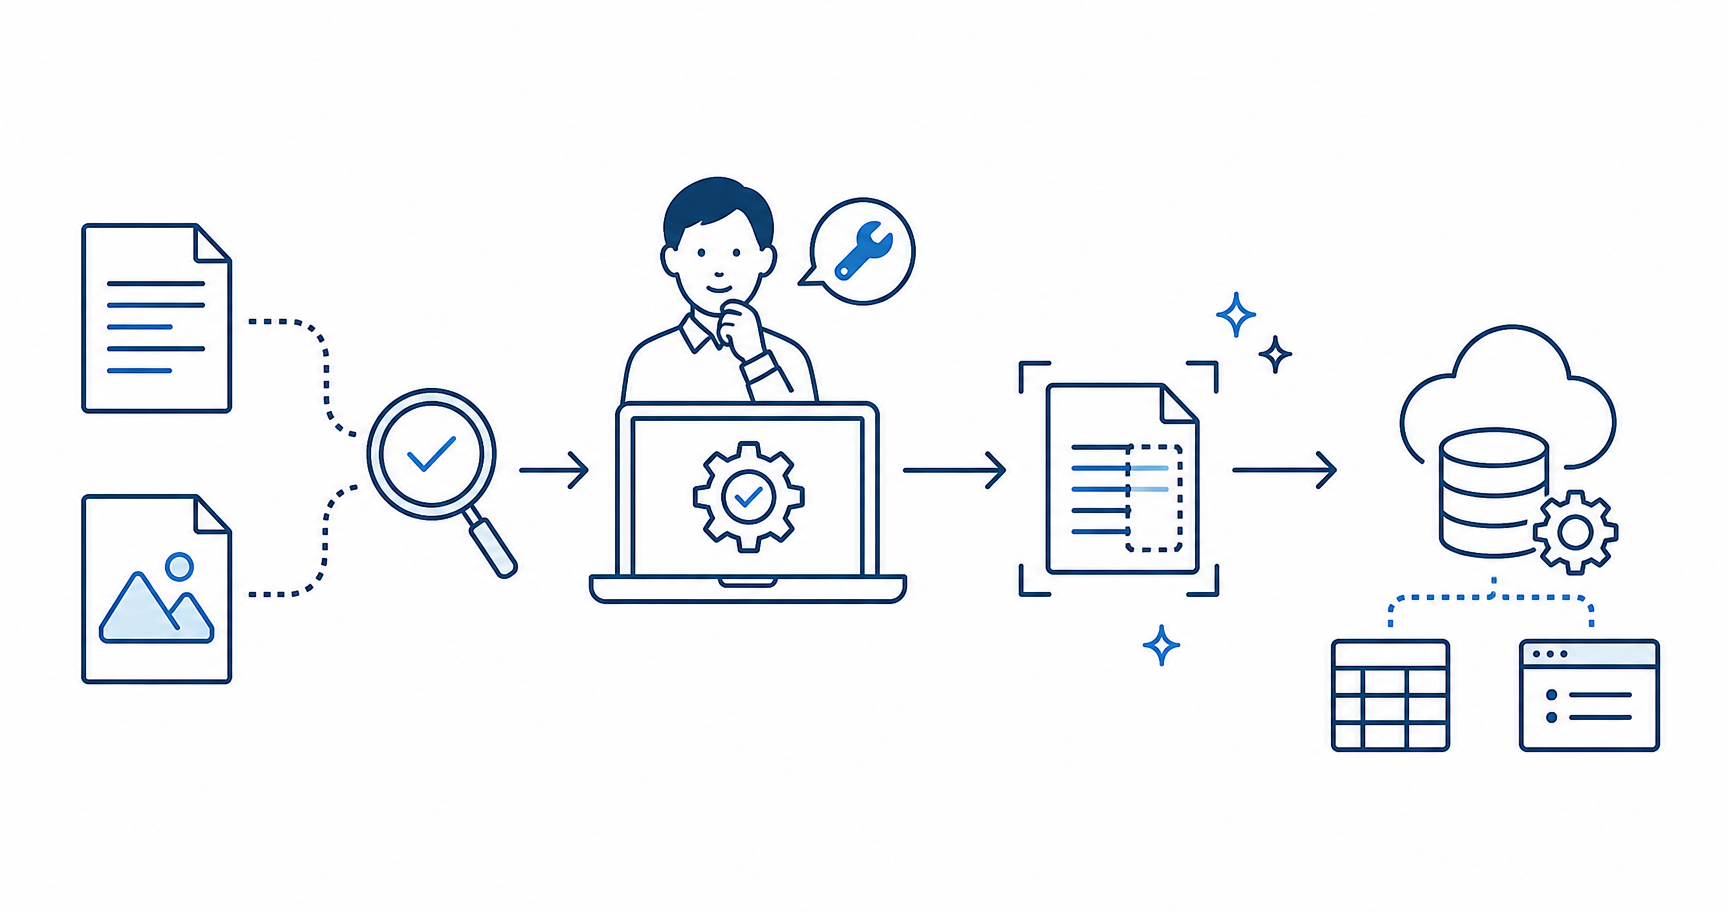
対象のPDFで文字を選択できるか試します。選べればテキストPDF、選べなければ画像PDF。ここでOCRが必要かどうかが決まります。
少量なら無料ツール、同じ帳票を毎月大量に処理するなら専用のAI OCRを選びます。処理する枚数と帳票のパターン数が、判断の軸です。
PDFを取り込み、読み取る項目(日付・金額・取引先など)を指定して抽出します。きれいなスキャン画像ほど、読み取りの精度は安定します。
読み取り結果の表記ゆれや誤変換を直し、Excelの形に整えます。マスタ照合や後処理のルールを決めておくと、毎回の手直しが減ります。
整えたデータを会計や基幹システムへ流し込み、確認の場所を業務に合わせて1か所決めます。最終チェックの位置を固定しておくのが、定着のコツです。
OCRでエラーが出るのはなぜ?原因と対処法
OCRのエラーは、解像度の不足・原稿の傾き・手書きのくずし字が主な原因です。スキャンの見直しと後処理で、多くは解決します。
読み取りがうまくいかないときは、ツールを疑う前に原稿の状態を確認してください。かすれ・影・斜めのスキャンは、どのOCRでも読み間違いのもとになります。
読み取り前のチェックポイント:原稿はまっすぐ、影やかすれのない状態でスキャンします。解像度が低いと文字がつぶれ、読み取りエラーが増えます。手書きのくずし字は、どんなOCRでも完璧には読めません。
開発の立場から正直にお伝えすると、OCRを入れれば全部が自動、とはなりません。読み取りの後に、表記ゆれや住所の補正、生成AIを使った後処理で正解へ近づけます。最後は人の目で確認します。
この「最後は人が見る」前提を正直に置いておくことが、かえって失敗を防ぎます。原因別の対処をさらに詳しく知りたい方は、次の記事もあわせてご覧ください。
開発元として伝えたい、ツール選びの考え方
ツールは「安いか高いか」ではなく、自社の業務に合うかどうかで選ぶのが、いちばん失敗が少ない方法です。
 相談者
無料ツールと有料のAI OCR、結局どちらを選べばいいのか迷ってしまいます。
 AI JIMY Labo
まずは無料ツールで十分なことも多いです。私たちも押し売りはしません。毎月同じ帳票を何百枚も処理して手が回らない、というときに初めて専用ツールの出番だと考えてください。
シー・システムは業務自動化を長く手がけ、必要に迫られてAI JIMYを開発してきました。だからこそ、費用対効果を最優先に、必要最低限の手段を中立に提案する姿勢を大切にしています。
開発元のシー・システムは創業44年、紙と手入力の現場に向き合い続けてきた会社です。AI JIMY Paperbotは、ITreview Grid Award 2026 SpringのOCRソフト部門で「Leader」を獲得しています。受賞の出典はITreviewの公式ページです。
AI JIMYは従量課金ではなく定額制で、年間の予算も立てやすい設計です。AI JIMY Portalの累計アカウント数は、2026年7月時点で5,700を超えています。まずは無料で、自社のPDFが読めるか試せます。
文字列の変換を手早く試したいなら、登録なしで使えるAI JIMY Converterもあります。定型帳票のテキスト抽出を自動化したいかどうかで、無理なく選んでください。
まとめ:PDFのテキスト抽出は「種類の見分け」から
PDFのテキスト抽出は、文字を選べるかどうかの見分けから始めれば、迷わず進められます。
- テキストPDFはコピーやWord変換、画像PDFはOCRで抽出する
- 少量は無料ツール、大量・定型の帳票は専用のAI OCRが近道
- OCRは万能ではない。最後は人が確認する前提で設計する
紙の手入力から解放された時間を、本来の仕事に戻す。その第一歩として、まずは自社の帳票で読み取りを試してみてください。資料で全体像を確かめたい方は、こちらもご活用ください。
PDFのテキスト抽出に関するよくある質問
PDFのテキスト抽出で、現場からよく寄せられる質問をまとめています。
- PDFのテキスト抽出は無料でできますか?
-
文字を選べるテキストPDFなら、WordやGoogleドキュメントの変換機能で無料で抽出できます。スキャンした画像PDFも、無料のOCRツールで少量なら対応できます。枚数が多い場合は専用ツールが向いています。
- スキャンした画像PDFからもテキストを抽出できますか?
-
できます。画像PDFはOCRで文字を認識してテキスト化します。読み取りの精度は原稿の状態に左右されるため、まっすぐで鮮明なスキャンを用意すると安定します。
- PDFからWordへの変換は品質が落ちませんか?
-
文字情報を持つテキストPDFなら、本文はおおむね正確に移せます。一方で表組みや段組みのレイアウトは崩れやすく、変換後に体裁を整え直す手直しが必要になることが多いです。
- オンラインの無料テキスト抽出ツールは安全ですか?
-
社外秘の書類をアップロードする場合は、データの取り扱い方針を事前に確認してください。安全性を重視するなら、ローカルで処理できるツールや、情報管理体制の整ったサービスを選ぶと安心です。
- OCRでエラーや文字化けが出るのはなぜですか?
-
解像度の不足、原稿の傾き、手書きのくずし字が主な原因です。スキャンをやり直して鮮明にし、読み取り後に表記ゆれを補正すると改善します。最終的には人の目でのチェックを前提にするのが確実です。
- 大量のPDFのテキスト抽出を自動化するには?
-
同じ様式の帳票を毎月大量に処理するなら、読み取りから転記までつなげられるAI OCRが向いています。抽出したデータをExcelや基幹システムへ自動で流し込めば、手入力をほぼなくせます。